· Marc Morel · Engineering · 11 min de lecture
De l'autocomplétion au harnais agentique
Quatre ères de l'ingénierie avec l'IA, et comment construire un bon harnais.
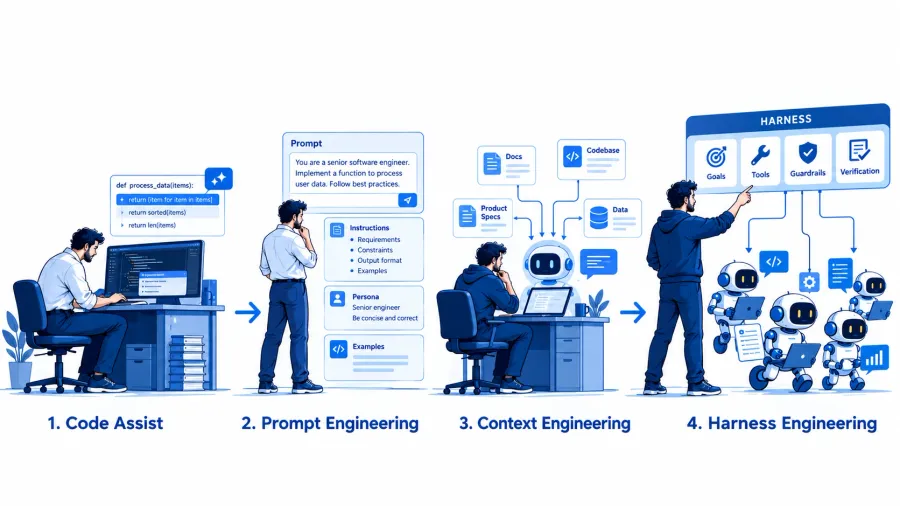
Quatre ères de l’ingénierie avec l’IA, et comment construire un bon harnais
En une poignée d’années, la façon dont les ingénieurs travaillent avec l’IA a changé quatre fois de centre de gravité. Chaque changement a déplacé l’effort d’ingénierie réel d’une couche supplémentaire loin du modèle lui-même.
D’abord, nous acceptions des suggestions. Puis nous avons soigné des instructions. Puis nous avons sélectionné ce que le modèle pouvait voir. Aujourd’hui, le savoir-faire consiste à construire le système entier dans lequel le modèle s’exécute : ses outils, ses limites, ses boucles de rétroaction. Ce système a désormais un nom, le harnais.
Cet article parcourt les quatre ères en regardant honnêtement ce que chacune nous a appris. Il se termine par la partie qui me tient le plus à cœur : comment construire un bon harnais, et comment choisir les méthodes et les outils qui le composent.
Les quatre ères en un coup d’œil
Chaque ère a élargi le périmètre de ce que nous concevons, et chacune vit encore à l’intérieur de la suivante. Vous écrivez toujours des prompts et sélectionnez toujours du contexte aujourd’hui ; vous le faites simplement à l’intérieur d’un harnais.
| Ère | Environ | Ce que vous concevez | Unité de travail | D’où vient le retour | Échec typique |
|---|---|---|---|---|---|
| Assistance au code | 2021–2023 | Presque rien : vous acceptez ou rejetez | Une ligne, une fonction | Vos propres yeux, dans l’éditeur | Du code plausible mais subtilement faux |
| Prompt engineering | 2023–2024 | L’instruction | Un échange unique | Vous relisez et reformulez | Des prompts fragiles qui cassent avec le modèle suivant |
| Context engineering | 2025 | Ce que voit le modèle | Une session, une fenêtre de contexte | La qualité de la récupération, puis la revue humaine | Un contexte périmé, contradictoire ou surchargé |
| Harness engineering | 2026 et au-delà | L’environnement dans lequel l’agent agit | Une tâche menée de bout en bout | Tests, linters, vérifications structurelles, agents de revue, signaux d’exécution | Un harnais qui dérive, ou des capteurs qui restent muets pour de mauvaises raisons |
Ère 1 : l’assistance au code, une autocomplétion plus intelligente
Tout a commencé dans l’éditeur. Un modèle observait le curseur et proposait la ligne suivante, puis la fonction suivante. Cela a semblé magique pendant environ deux semaines.
Puis les limites sont apparues. L’assistant connaissait le langage mais pas le système. Il suggérait du code qui compilait, semblait idiomatique, et ignorait discrètement la frontière du module, la convention de gestion d’erreurs ou la raison d’être de ce helper. Dans les grandes organisations, j’ai vu l’adoption plafonner rapidement : des fonctions locales et des tests unitaires, réécrits par le développeur plus souvent qu’acceptés tels quels.
Ce qu’elle nous a appris : la vitesse sans la compréhension reporte le coût sur la revue. Les taux d’acceptation étaient une métrique de vanité. Le développeur restait le seul harnais, et personne n’avait conçu ce harnais délibérément.
Ère 2 : le prompt engineering, l’instruction comme savoir-faire
Les interfaces de chat ont fait sortir la conversation de l’éditeur. Soudain, la qualité de la réponse dépendait visiblement de la qualité de la question. Nous avons appris les rôles, les exemples, le raisonnement étape par étape, les formats de sortie explicites.
Cette discipline était réellement utile, et elle l’est toujours : une instruction claire et bien structurée bat une instruction vague avec n’importe quel modèle. Mais les prompts avaient trois faiblesses qu’aucun savoir-faire ne pouvait corriger. Ils étaient rarement versionnés ou testés. Ils étaient réglés pour un modèle et se dégradaient avec le suivant. Et aussi bonne que soit la formulation, le modèle ne savait toujours rien de votre système.
Ce qu’elle nous a appris : la clarté est nécessaire, pas suffisante. Les équipes ont constitué des bibliothèques de prompts qui sont devenues du folklore. Le plafond n’a jamais été la formulation ; c’était ce que le modèle ne pouvait pas voir.
Ère 3 : le context engineering, sélectionner ce que voit le modèle
Vers la mi-2025, le vocabulaire a changé. La question n’était plus comment demander, mais quoi placer devant le modèle : quels fichiers, quelle documentation, quelles conventions, quels résultats d’outils, dans quel ordre.
Cette ère a apporté l’indexation des bases de code, la récupération, des fichiers de règles chargés à chaque session, des outils qui récupèrent du contexte à la demande, et des techniques pour compacter les longues sessions. Elle a aussi apporté une leçon contre-intuitive : plus de contexte n’est pas un meilleur contexte. Une fenêtre bourrée de contenu marginalement pertinent dégrade le raisonnement. La sélection l’emporte sur le volume.
Ce que le context engineering ne pouvait pas faire, c’est boucler la boucle. Il augmente la probabilité d’une bonne première tentative, mais rien en lui ne dit à l’agent si la tentative a réussi. Un agent parfaitement informé peut encore se tromper, et personne ne s’en aperçoit avant qu’un humain relise le diff.
Ère 4 : le harness engineering, concevoir l’environnement
Le terme s’est imposé début 2026. OpenAI a décrit comment l’une de ses équipes construisait du logiciel avec des agents écrivant le code, et a conclu que ses problèmes les plus difficiles s’étaient déplacés vers les environnements, les boucles de rétroaction et les systèmes de contrôle. Un raccourci s’est diffusé avec : Agent = Modèle + Harnais. Le harnais, c’est tout sauf le modèle.
Le modèle mental le plus utile que j’ai trouvé vient de Birgitta Böckeler. Il sépare deux choses :
- Le harnais du constructeur est ce qui est livré dans l’agent de code : son prompt système, sa boucle, sa gestion du contexte. Vous le choisissez ; vous le modifiez rarement.
- Le harnais de l’utilisateur est ce que votre équipe construit autour, spécifique à votre base de code et à vos conventions. C’est là que se fait le harness engineering.
Elle classe ensuite chaque contrôle selon deux axes. Les guides agissent avant l’agent et augmentent les chances d’une bonne première tentative. Les capteurs agissent après et permettent à l’agent de se corriger. Chacun peut être computationnel (déterministe, rapide, peu coûteux : types, linters, tests) ou inférentiel (sémantique, plus lent, probabiliste : un relecteur IA). Des guides seuls vous donnent un agent qui n’apprend jamais s’il s’est conformé. Des capteurs seuls vous en donnent un qui répète la même erreur indéfiniment.
Le vrai changement est une question de posture. Le context engineering informe l’agent. Le harness engineering le régule, et traite chaque erreur récurrente comme un défaut du harnais plutôt que du modèle.
Anatomie d’un harnais
L’agent se trouve au milieu, alimenté par les guides à gauche et corrigé par les capteurs à droite, à l’intérieur d’un environnement qui limite ce qu’il peut toucher. Au-dessus, l’humain ne relit pas chaque ligne : il améliore les guides et les capteurs chaque fois que le même échec se présente deux fois.
Construire un bon harnais
Un harnais n’est pas une configuration que l’on écrit une fois. C’est un produit que l’on fait grandir à partir des faits. Voici la méthode que je suivrais sur n’importe quelle base de code.
- Partir des échecs, pas des fonctionnalités. Pendant deux semaines, consignez toutes les façons dont l’agent se trompe dans votre base de code : mauvaise couche, API inventée, test sauté, correction sur-conçue. Ce backlog est la feuille de route de votre harnais.
- Corriger d’abord la harnachabilité. Un typage fort, des frontières de modules claires, une suite de tests rapide que l’agent peut exécuter, et un environnement reproductible sont ce qui rend les contrôles possibles. Sur une base de code legacy, cette étape est la plus difficile, et la plus précieuse.
- Garder des guides légers. Un
AGENTS.mdcourt avec les commandes de build et de test, les frontières à ne pas franchir, et où se trouvent les choses. Poussez les procédures détaillées dans des skills chargées à la demande. Les longs fichiers d’instructions sont ignorés en commençant par le bas. - Faire des capteurs computationnels la colonne vertébrale. Vérifications de types, linters, tests structurels et tests unitaires rapides, branchés sur des hooks pour s’exécuter à chaque modification. Écrivez leurs messages d’erreur pour l’agent : dites ce qui ne va pas et comment le corriger.
- Ajouter des capteurs inférentiels là où le calcul ne peut pas aller. Un agent de revue au mandat étroit (sécurité, conception d’API, qualité des tests) et, pour les tâches longues, un évaluateur distinct plutôt que de laisser l’auteur noter son propre travail.
- Placer chaque contrôle selon son coût. Les vérifications rapides avant le commit, les coûteuses comme le mutation testing et la revue à contexte large dans le pipeline, la détection de dérive sur planification. La qualité reste à gauche ; rien n’attend un humain qu’une machine aurait pu attraper.
- Rendre le travail long reprenable. Des notes d’avancement, une checklist de fonctionnalités et des commits fréquents permettent à une nouvelle session de reprendre là où la précédente s’est arrêtée, au lieu de se fier à une mémoire compactée.
- Contenir le rayon d’impact. Un bac à sable jetable, des listes blanches explicites pour les commandes et le réseau, et une approbation pour tout ce qui est irréversible.
- Faire tourner la boucle de pilotage. Tout échec vu deux fois devient un nouveau guide ou capteur. Versionnez le harnais comme du code, relisez ses modifications, et auditez-le régulièrement pour repérer les règles qui se contredisent.
- Mesurer le harnais lui-même. Acceptation au premier passage, taux de reprise, temps de revue humaine par modification, fréquence de déclenchement de chaque capteur. Un capteur qui ne se déclenche jamais ne prouve rien tant que vous n’avez pas montré qu’il le peut.
Une fois que cela fonctionne pour un service, packagez-le. La plupart des organisations ont quelques formes de services récurrentes ; un modèle de harnais par forme est la façon de passer à l’échelle au-delà d’une seule équipe enthousiaste.
Choisir les méthodes et les outils
Choisissez les outils selon la couche du harnais qu’ils servent, et jugez-les sur la façon dont ils s’intègrent à la boucle plutôt que sur leur liste de fonctionnalités. Les options ci-dessous sont celles que j’évaluerais en premier ; le marché évolue vite, donc considérez ces noms comme une première liste restreinte.
| Couche du harnais | Méthode | Outils à évaluer | Ce qu’il faut vérifier avant de choisir |
|---|---|---|---|
| Agent de code (harnais du constructeur) | Choisir un agent principal par équipe, en garder un second pour comparer | Claude Code, OpenAI Codex CLI, Gemini CLI, Cursor, OpenCode | Hooks, modèle de permissions, sous-agents, mode headless pour la CI, choix du modèle |
| Guides : conventions et procédures | Un fichier léger toujours chargé, des skills détaillées à la demande | AGENTS.md, Agent Skills (SKILL.md) | Supporté nativement par votre agent, versionné dans le dépôt |
| Guides : intention | Le développement piloté par les spécifications : la spec est le feedforward du comportement | GitHub Spec Kit, OpenSpec, Kiro | Specs lisibles par des humains, comparables en diff, liées aux tests |
| Guides : intelligence du code | Donner à l’agent la vue du compilateur, pas seulement du texte | Language servers, recettes OpenRewrite, codemods | Fonctionne en headless, sortie déterministe |
| Capteurs : rapides et computationnels | S’exécutent à chaque modification via des hooks | Vérificateurs de types stricts, ESLint, Ruff, Semgrep | S’exécutent en quelques secondes, messages exploitables par un agent |
| Capteurs : fitness de l’architecture | Encoder les frontières sous forme de tests | ArchUnit, dependency-cruiser | Les règles vivent dans le code, échouent avec une explication claire |
| Capteurs : qualité des tests | Vérifier que les tests écrits par l’agent peuvent réellement échouer | Stryker, PIT (mutation testing) | Abordable dans le pipeline, mode incrémental |
| Capteurs : inférentiels | Des agents de revue au mandat étroit, un évaluateur distinct pour les tâches longues | Skills de revue ou sous-agents dans votre agent de code | Une préoccupation par relecteur, constats traçables |
| Évaluation du harnais | Tester la non-régression du harnais quand les guides, les skills ou les modèles changent | promptfoo, Inspect AI | Jeux de tâches reproductibles issus de votre propre base de code |
| Environnement | Des espaces de travail jetables et au moindre privilège | Dev containers, bacs à sable en conteneurs ou microVM | Listes blanches réseau, réinitialisation rapide, aucun identifiant de production |
| Observabilité | Tracer chaque exécution d’agent de bout en bout | Conventions OpenTelemetry GenAI, Langfuse | Coût, tokens, appels d’outils et résultats des capteurs dans une seule trace |
Trois règles de sélection comptent davantage que n’importe quel outil. Préférez les formats ouverts (AGENTS.md, SKILL.md, MCP) pour que le harnais survive à un changement d’agent. Préférez les contrôles déterministes, et n’ajoutez des contrôles inférentiels que là où rien de computationnel ne peut faire le travail. Comptez le coût de maintenance : chaque guide et chaque capteur est du code que quelqu’un doit garder cohérent.
Ce qui change
Le savoir-faire s’est déplacé, la responsabilité non
Chaque ère a repoussé l’ingénierie d’une couche vers l’extérieur, de la ligne de code à l’environnement autour de l’agent. Ce qui n’a jamais bougé, c’est la responsabilité. Un harnais ne supprime pas l’humain ; il dirige l’attention humaine vers les endroits où le jugement compte le plus : l’intention, les arbitrages, et le comportement que personne n’a encore appris à tester automatiquement.
La bonne nouvelle, c’est que le harness engineering est surtout de l’ingénierie que nous connaissons déjà. Types, tests, linters, fitness functions, bacs à sable, observabilité. Ce qui est nouveau, c’est que nous les construisons désormais pour un collègue qui travaille vite, ne se fatigue jamais, et n’a aucun souvenir de la veille.