· Marc Morel · Engineering · 13 min de lecture
Profiler, générer, prouver : une méthode pour des données synthétiques fidèles à la production
Dans la partie 1, j'ai expliqué pourquoi des scénarios de test écrits à la main gardaient nos tests au vert pendant que les dates de livraison glissaient, et pourquoi la réponse réside dans des données qui portent la forme de la production par construction. Cet article décrit la méthode en trois étapes : profiler, générer, prouver.
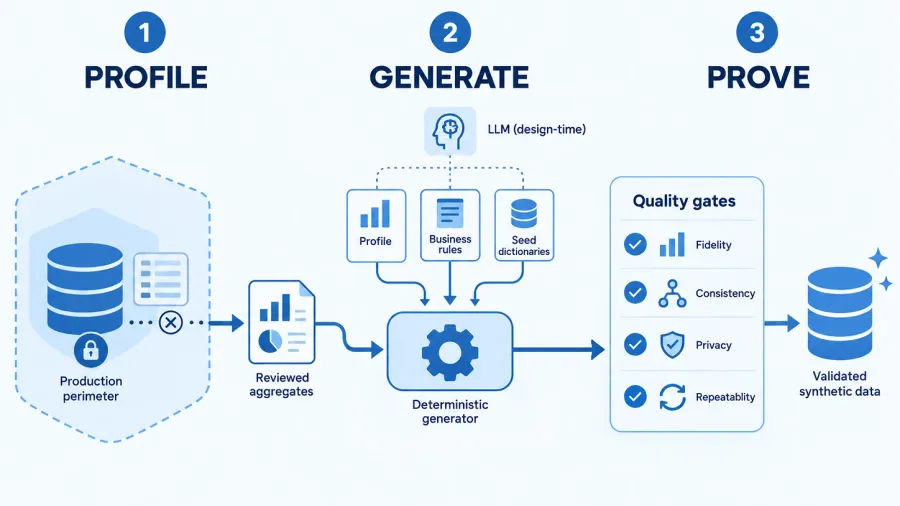
Une règle traverse les trois étapes. Aucune ligne de production ne quitte jamais le périmètre de production ; seuls des agrégats revus en sortent. Chaque technique ci-dessous est choisie pour fonctionner à partir de ces seuls agrégats.
Étape 1 : profiler la production, en toute sécurité
Tout commence par un portrait statistique de la production, calculé là où vivent les données. Le profileur est un job planifié qui s’exécute à l’intérieur du périmètre de production. Il lit, agrège et n’exporte qu’un profil.
Ce que capture le profil, du plus simple au plus précieux :
- Distributions marginales. La pyramide des âges des clients, la répartition des catégories de produits, le partage entre canaux, les distributions de montants par type de transaction. Les champs catégoriels deviennent des tables de fréquences ; les champs continus deviennent des histogrammes par classes ou des lois paramétriques ajustées.
- Distributions jointes et corrélations. L’âge seul ne suffit pas : la pyramide des âges des détenteurs de cartes premium diffère de celle des comptes d’entrée de gamme. Capturez les paires et triplets qui comptent pour votre charge de travail, comme âge × segment, région × catégorie ou ancienneté × tranche de solde, plus une matrice de corrélation pour les champs continus.
- Cardinalités et asymétrie. Produits par client, transactions par compte et par jour, part du trafic portée par le top 1 % des commerçants. L’asymétrie crée des partitions chaudes, et les partitions chaudes sont précisément ce que les tests de performance existent pour trouver.
- Motifs temporels. Saisonnalité quotidienne et hebdomadaire, pics de fin de mois, pics les jours de paie, temps entre deux événements.
- Fréquences de transitions d’état. À quelle fréquence un compte passe d’ouvert à actif, d’actif à dormant, de dormant à clôturé, et combien de temps prend chaque étape.
Garde-fous de confidentialité
Les agrégats sont plus sûrs que les lignes, mais pas automatiquement sûrs. Des combinaisons rares peuvent encore désigner une seule personne. Appliquez ces règles avant que tout profil ne franchisse le périmètre :
- Taille minimale de cellule. Supprimez ou fusionnez toute classe sous un seuil convenu avec votre délégué à la protection des données.
- Généralisation. Regroupez les âges en tranches, arrondissez les montants, tronquez les codes postaux au niveau dont votre test a réellement besoin.
- Du bruit là où c’est nécessaire. Pour les tables jointes sensibles, ajoutez un bruit calibré (confidentialité différentielle). Des bibliothèques comme OpenDP rendent cela praticable.
- Uniquement des champs sur liste blanche. Le profileur exporte ce que déclare la spécification, rien d’autre. Les colonnes en texte libre ne sont jamais profilées telles quelles.
Le profil est lui-même un artefact versionné : un ensemble de fichiers JSON ou Parquet, revus, signés et stockés à côté du code du générateur. Quand le marché évolue, vous rafraîchissez le profil, pas le code.
Étape 2 : générer avec trois couches coopérantes
La génération n’est pas un modèle unique. Ce sont trois couches, chacune faisant ce qu’elle fait le mieux, reliées par une seule spécification déclarative.
Couche 1 : le cœur statistique
Cette couche échantillonne les attributs des entités pour que les marginales et les corrélations correspondent au profil. Comme seuls des agrégats quittent le périmètre, les techniques doivent fonctionner à partir d’agrégats, pas de lignes :
- Chaînes d’échantillonnage conditionnel. Échantillonner d’abord le segment, puis la tranche d’âge sachant le segment, puis la région sachant la tranche d’âge, chaque étape lisant une table profilée. Simple, rapide et transparent pour les relecteurs.
- Copules gaussiennes. Elles n’ont besoin que de la distribution marginale de chaque variable et d’une matrice de corrélation, que le profil exporte déjà toutes les deux. Elles préservent les corrélations entre champs continus comme l’âge, la tranche de revenu et le solde.
- Modèles graphiques fondés sur les marginales. Quand les dépendances forment un graphe plutôt qu’une chaîne, ajustez un modèle sur les tables jointes exportées. Des méthodes comme PrivBayes, MST ou Private-PGM ont été conçues exactement pour cela : synthétiser des données à partir de marginales bruitées.
Les bibliothèques entraînées sur des lignes comme SDV restent une option, mais uniquement à l’intérieur du périmètre. Entraînez-y le modèle, idéalement avec de la confidentialité différentielle, et ne laissez le modèle ajusté franchir le périmètre qu’après la même revue que tout profil.
Exécutez cette couche sur une stack colonnaire et vectorisée comme Polars ou DuckDB. Générer des attributs par lots de plusieurs millions est bien plus rapide que du code ligne par ligne.
Couche 2 : simulation du cycle de vie
C’est la couche qui élimine les états incohérents. Au lieu de générer chaque table indépendamment, le moteur simule les entités dans le temps.
Chaque entité métier (client, compte, carte, contrat) est décrite par une machine à états : états, transitions autorisées, gardes et distributions temporelles issues du profil. Le simulateur crée un client, ouvre un compte après un délai échantillonné, émet une carte, produit des transactions et peut plus tard clôturer le compte. Le temps simulé avance en mémoire, donc des années d’historique prennent quelques secondes. Comme chaque enregistrement est la conséquence d’une transition légale, clés étrangères, horodatages et statuts sont cohérents par construction.
Au-dessus des machines à états, un ensemble d’invariants sert de filet de sécurité : un compte clôturé ne porte aucune nouvelle transaction, un remboursement ne dépasse jamais son paiement, un solde est égal à la somme de ses mouvements. Tout enregistrement qui viole un invariant fait échouer l’exécution.
Couche 3 : règles et dictionnaires rédigés par le LLM
Le LLM ne contribue qu’au moment de la conception, et tout ce qu’il produit est revu avant que le moteur ne l’utilise :
- Extraction de règles. Donnez au LLM votre DDL, vos définitions d’enums, votre code de validation et vos contrats d’API. Demandez-lui de rédiger les machines à états et les invariants dans le format de votre spécification. Les ingénieurs les relisent et les fusionnent comme n’importe quelle pull request.
- Dictionnaires de base. Le LLM constitue les valeurs dans lesquelles le moteur échantillonne : noms d’entreprises, libellés de commerçants, et modèles pour les champs en texte libre comme les références de virement ou les notes du support. La section suivante les détaille.
- Catalogues de cas limites. Demandez au LLM quelles situations inhabituelles mais légales votre domaine autorise : comptes joints, mineurs avec un tuteur, clients transfrontaliers, comptes rouverts après clôture. Chacune devient un scénario avec une fréquence explicite, issue du profil. C’est précisément la diversité que nos scénarios écrits à la main n’ont jamais atteinte.
À l’exécution, il n’y a aucun appel au LLM. Le texte libre est assemblé à partir de modèles et de dictionnaires revus, ce qui garde chaque exécution rapide, peu coûteuse et reproductible.
La spécification relie le tout
Un seul fichier déclaratif (YAML ou un DSL typé) décrit les entités, les champs du profil dans lesquels chaque attribut échantillonne, les dictionnaires, les machines à états, les invariants et les volumes cibles. C’est le contrat entre le profil, les règles rédigées par le LLM et le moteur. Gardez-le dans Git, relisez-le, et traitez ses modifications comme des modifications de code de production.
Dictionnaires de base : l’idée de Faker, ancrée dans votre marché
Les statistiques disent au moteur à quelle fréquence une valeur apparaît ; les dictionnaires de base lui disent quelles valeurs existent. Ce sont les listes constituées dans lesquelles puise chaque enregistrement réaliste : fournisseurs d’e-mail, prénoms et noms de famille, noms d’entreprises, villes, noms de rues. (À ne pas confondre avec la graine aléatoire qui rend chaque exécution reproductible.) Si vous avez utilisé Faker en Python ou Datafaker en Java, vous connaissez l’idée. La différence est que chaque valeur est associée à un poids mesuré sur votre propre marché, et non tirée uniformément d’une locale générique.
Fournisseurs d’e-mail grand public
La répartition des fournisseurs est nationale : gmail.com, orange.fr, free.fr et hotmail.com dominent en France ; gmx.de, web.de et t-online.de en Allemagne. L’asymétrie compte, parce que les colonnes de domaine alimentent index, partitions et règles anti-fraude. Les valeurs viennent des locales Faker et de listes publiques, complétées par le LLM pour la longue traîne. Les poids viennent de la part de chaque domaine par pays dans le profil, les domaines rares étant fusionnés dans une catégorie « autre ». Les parties locales sont construites à partir du nom synthétique du client, selon des motifs profilés (prenom.nom, p.nom, nom suivi de chiffres).
Prénoms et noms, par pays et par écriture
Les noms viennent de dictionnaires par locale, pondérés par pays et par année de naissance. Leur structure suit les conventions locales :
- Ordre et forme. Le nom de famille d’abord en Chine, au Japon, en Corée et en Hongrie ; deux noms de famille en Espagne et au Portugal ; des patronymes en Russie ; des noms uniques dans certaines régions d’Indonésie.
- Écritures. Les clients de locales non latines portent la forme native (王伟, Иван Петров, 佐藤花子, محمد العلي) et sa translittération standard (Pinyin, ISO 9, Hepburn). Les e-mails utilisent la forme translittérée, sauf si vous testez des adresses internationalisées.
- Caractères difficiles. Diacritiques (é, ß, ł), apostrophes et traits d’union (O’Brien, Jean-Pierre) apparaissent à leur fréquence réelle.
C’est là que des noms réalistes sont payants : ils sollicitent l’encodage, la collation, le tri, la recherche et les validateurs qui les rejettent en production.
Noms d’entreprises et e-mails professionnels
Le LLM génère des noms d’entreprises fictifs par secteur et par pays, avec leurs formes juridiques (SAS, GmbH, Ltd), filtrés au regard de registres ouverts comme SIRENE. Chaque entreprise obtient un domaine d’entreprise et des adresses : prenom.nom@entreprise.fr pour les salariés, plus contact@ ou factures@. La taille d’entreprise profilée fixe l’effectif, de trois adresses à plusieurs centaines.
Cohérence avec le reste de l’enregistrement
Les valeurs de base deviennent vraiment réalistes quand elles concordent avec l’entité qu’elles décorent :
- Les prénoms suivent la pyramide des âges. Les prénoms populaires changent selon les décennies. Des jeux de données ouverts, comme le fichier des prénoms de l’INSEE en France, donnent des fréquences par année de naissance, donc un client né en 1962 reçoit un prénom courant en 1962.
- Les fournisseurs suivent la géographie. Un client vivant en Allemagne puise dans la répartition des fournisseurs allemands, pas français.
- Les adresses sont des lieux réels. Noms de rues, codes postaux et villes viennent de données d’adresses ouvertes, comme la Base Adresse Nationale en France, donc le géocodage et la validation des codes postaux se comportent comme en production.
- L’unicité est un invariant. Deux clients ne doivent jamais partager un e-mail. Les collisions sont résolues de façon déterministe, avec un suffixe numérique dérivé de la graine aléatoire, et la barrière de cohérence le vérifie.
Un mot de prudence : les vrais domaines atteignent de vraies personnes
Une adresse synthétique sur gmail.com peut très bien appartenir à une personne réelle. Si un environnement de test envoie un jour une notification, cette personne la reçoit. Routez chaque e-mail sortant des environnements hors production vers un puits de capture comme Mailpit, et bloquez le SMTP externe au niveau réseau. Quand un test n’a pas besoin d’une répartition réaliste des domaines, préférez le domaine réservé example.com ou l’extension .test (RFC 2606).
À quoi ressemble un dictionnaire
Chaque dictionnaire est un petit fichier versionné qui liste les valeurs, la locale, ainsi que la source et la licence des valeurs comme des poids. Il est relu comme du code, à côté du profil et de la spécification.
dictionary: consumer_email_providersversion: 2026.10.1locale: fr_FRweights_from: profile/email_domain_share_fr.parquetvalues_from: [faker:fr_FR, public-provider-list, llm-curated]entries: - domain: gmail.com - domain: orange.fr - domain: free.fr - domain: hotmail.com - domain: laposte.netother_bucket: public-provider-listLes poids sont volontairement absents du fichier : ils vivent dans le profil et sont joints au moment de la génération. Rafraîchir la répartition du marché est alors une mise à jour du profil, sans modification du dictionnaire.
Étape 3 : le prouver avant de s’y fier
Un jeu de données synthétiques est un livrable, il a donc une barrière qualité. Chaque exécution de génération est vérifiée au regard du profil dont elle est issue, et l’exécution échoue si une barrière échoue. C’est l’inverse de nos anciens tests, si facilement au vert : ici, la barre est fixée par la production, pas par notre imagination.
| Barrière | Ce qu’elle vérifie | Méthode typique |
|---|---|---|
| Fidélité marginale | Chaque colonne correspond à sa distribution profilée | Test de Kolmogorov–Smirnov pour les champs continus, distance de variation totale pour les champs catégoriels |
| Fidélité jointe | Les corrélations et tableaux croisés clés sont préservés | Écart de matrice de corrélation ; comparaison avec les tables jointes du profil |
| Asymétrie et cardinalité | Les clés chaudes et les fan-outs ressemblent à la production | Part du top N, percentiles d’enfants par parent |
| Cohérence | Aucun invariant ni règle de machine à états n’est violé | Assertions SQL sur le jeu de données complet (DuckDB fonctionne bien) |
| Confidentialité | Aucune sortie ne reproduit une combinaison plus rare que la taille minimale de cellule | La génération n’utilise que des agrégats validés, il s’agit donc d’une vérification de la sortie au regard du profil, pas d’une comparaison avec des lignes réelles |
| Réalisme de la charge | Le système se comporte comme en production | Taux de hit du cache, plans de requête et chaleur des partitions sur une exécution de smoke test, comparés à la télémétrie de production |
La dernière barrière est celle que les équipes sautent et qu’elles regrettent ensuite. La fidélité statistique est nécessaire, mais le vrai test est comportemental : la base de données choisit-elle les mêmes plans, le cache fait-il des hits au même taux, les mêmes partitions chauffent-elles ? La télémétrie de production ne contient aucune donnée client, donc cette comparaison reste dans le cadre de la règle de confidentialité.
Quand une barrière échoue, le LLM prouve son utilité une seconde fois. Donnez-lui le rapport d’échec, la spécification et la règle concernée, et demandez-lui d’expliquer l’écart et de proposer une correction. Un ingénieur approuve toujours la modification, mais la boucle passe d’une journée d’investigation à quelques minutes.
Ce qui change
La barre est fixée par la production, pas par notre imagination
Les scénarios écrits à la main testent ce à quoi nous avons pensé. Cette méthode teste ce que fait réellement la production. Chaque étape fait passer une décision de l’intuition de quelqu’un à un artefact qui peut être revu :
- Profiler. « À quoi ressemble la production ? » cesse d’être une supposition. Cela devient un ensemble versionné d’agrégats, calculés à l’intérieur du périmètre et vérifiés pour la confidentialité avant de sortir.
- Générer. Le réalisme cesse d’être artisanal. Les statistiques décident de la fréquence d’apparition d’une valeur, les dictionnaires de base décident des valeurs qui existent, et la simulation du cycle de vie fait de chaque enregistrement le résultat d’une transition légale. Les états incohérents disparaissent par construction au lieu d’être traqués un bug à la fois.
- Prouver. Une exécution au vert cesse d’être un acte de foi. Chaque jeu de données passe les mêmes barrières de fidélité, de cohérence, de confidentialité et de charge, et une barrière en échec fait échouer l’exécution.
Le rôle du LLM change aussi. Il n’invente plus de données de test ; il rédige des règles, constitue des dictionnaires et liste des cas limites au moment de la conception, puis explique les barrières en échec. Les ingénieurs relisent tout ce qu’il produit, et aucun modèle n’est appelé à l’exécution, donc chaque exécution reste rapide, peu coûteuse et reproductible.
Ce que vous maintenez change également. Au lieu d’une pile croissante de fixtures, vous conservez trois choses dans Git : un profil, une spécification et un ensemble de dictionnaires. Quand le marché évolue, vous rafraîchissez le profil, pas le code. Et tout au long, une règle tient : aucune ligne de production ne quitte jamais le périmètre de production.