· Marc Morel · Engineering · 6 min de lecture
Pourquoi des tests au vert étaient le problème
Nous avions tout bien fait : des scénarios clairs, des jeux de données réalistes, le tout sous gestion de versions. Pourtant, chaque fois que nous rencontrions des données proches de la production, de nouveaux bugs apparaissaient. Nous ne pouvions plus dire quand nous aurions terminé. La leçon : des données synthétiques à grande échelle, construites à partir de profils réels, corrigent la forme d'imprévisibilité la plus coûteuse.
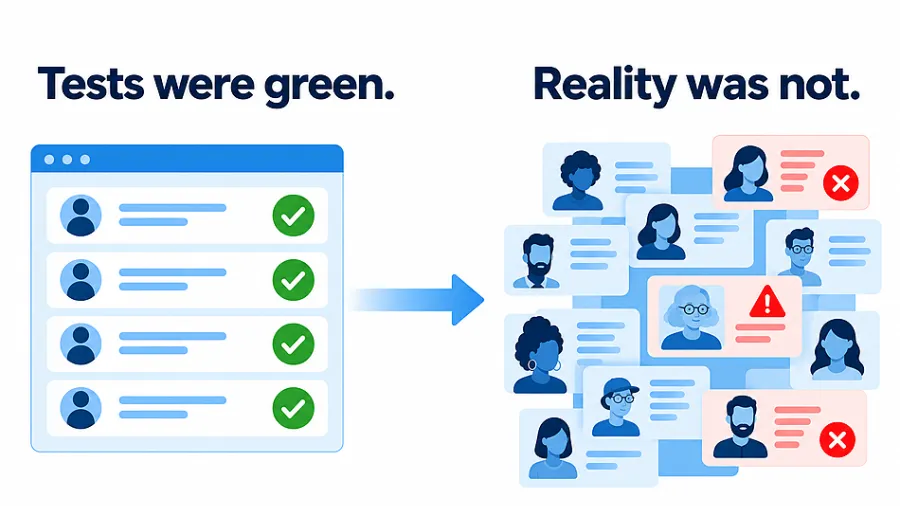
Nos tests étaient au vert. C’était bien le problème.
Sur un précédent grand projet, nous avons fait ce que font la plupart des équipes. Nous avons écrit nos cas de test à la main. Chaque scénario décrivait un client, un produit, un parcours et le résultat attendu. Nous avons construit de petits jeux de données soigneusement choisis pour les alimenter, nous les avons relus, et nous les exécutions à chaque build.
Ils passaient. Presque toujours, et presque immédiatement.
Il nous a fallu du temps pour comprendre ce que ce vert signifiait vraiment. Nos scénarios décrivaient le monde tel que nous l’imaginions : des clients bien rangés, des produits courants, des parcours qui suivaient le chemin nominal ou la poignée d’exceptions auxquelles nous avions pensé.
Le monde réel est bien plus divers.
Les vrais clients ont de longs historiques, des combinaisons inhabituelles de produits, des noms et des adresses que nos validateurs n’avaient jamais vus, et des états que seules des années d’activité produisent. Rien de tout cela n’était dans nos jeux de données, donc rien de tout cela n’était testé.
La conséquence n’a pas été une panne spectaculaire. C’était quelque chose de plus lent et de plus coûteux : l’imprévisibilité. Chaque fois que le système rencontrait des données réalistes, en intégration, en pré-production ou lors d’une répétition de migration, de nouveaux défauts apparaissaient. Chacun rouvrait un travail que nous considérions comme terminé. Les estimations glissaient, puis glissaient encore, parce que le vrai travail n’apparaissait qu’une fois la diversité du monde réel au rendez-vous. Nous ne pouvions plus dire avec assurance quand quelque chose serait fini.
La leçon était inconfortable mais claire. Un test au vert mesurait nos scénarios, pas notre système. Des cas écrits à la main ne peuvent pas suivre la diversité combinatoire de la production, aussi soigneusement soient-ils rédigés. Il nous fallait des données qui portent la forme de la réalité par construction, au volume que la réalité produit.
Trois façons dont les données de test mentent
Avec le recul, nos jeux de données échouaient de trois façons récurrentes. J’ai depuis retrouvé le même schéma dans des campagnes de performance ailleurs.
- Volume et forme insuffisants. Quelques milliers de lignes clonées un million de fois. Chaque client ressemble à tous les autres, donc les caches font bien trop de hits et les index ne rencontrent jamais leur cardinalité réelle.
- Valeurs irréalistes. Des âges répartis uniformément de 18 à 99 ans, toutes les catégories de produits aussi populaires les unes que les autres, tous les montants ronds. Plans de requête, élagage de partitions et clés chaudes se comportent tous différemment de ce qu’ils feront en production.
- États incohérents. Un compte clôturé avant d’avoir été ouvert. Une carte émise pour un client qui n’existe pas. Un remboursement supérieur au paiement qu’il annule. Ces enregistrements soit font planter l’exécution, soit, pire, font passer le trafic par des chemins de code que les vrais utilisateurs n’empruntent jamais.
La bonne nouvelle : nous possédons déjà la meilleure spécification possible de données réalistes. C’est notre système de production, décrit non pas ligne par ligne, mais statistiquement.
Les données synthétiques comme solution
Des plateformes commerciales comme Tonic.ai résolvent bien ce problème. Elles se connectent à vos bases de données, apprennent leur structure et produisent des copies anonymisées ou synthétiques en préservant l’intégrité référentielle. Si votre besoin est large, urgent et réparti sur des dizaines de schémas, acheter est souvent le bon choix. Le prix, en revanche, est significatif, et il augmente avec les sources de données et l’usage.
Construire a aussi un coût, et il mérite la même honnêteté : du temps d’ingénierie pour livrer le premier parcours critique, puis un engagement durable à maintenir profils, règles et dictionnaires au fil de l’évolution du métier. Des bibliothèques open source comme SDV réduisent ce coût, mais aucune n’encode vos règles métier ou votre marché à votre place.
Une solution interne ne vaut le coup que si elle apporte quatre choses qu’apporterait un éditeur :
| Exigence | Ce que cela signifie en pratique |
|---|---|
| Fidélité | Distributions et corrélations correspondent à la production dans des tolérances convenues |
| Cohérence | Chaque enregistrement respecte les invariants métier et les règles de cycle de vie |
| Confidentialité par construction | Aucune ligne de production ne quitte jamais son périmètre ; seuls des agrégats validés en sortent |
| Échelle et reproductibilité | Des centaines de millions de lignes, régénérées à l’identique à partir d’une graine aléatoire |
Si vous ne pouvez pas vous engager sur les quatre, achetez. Si vous le pouvez, l’approche ci-dessous est volontairement petite, construite à partir de briques open source, et centrée sur le domaine que vous connaissez mieux que n’importe quel éditeur.
L’idée clé : laisser le LLM écrire le générateur, pas les lignes
La conception la plus tentante est aussi la pire : demander à un LLM « 10 000 clients réalistes » et recommencer jusqu’à en avoir assez. Elle échoue sur toutes les exigences ci-dessus. Elle est lente et coûteuse par ligne, elle ne peut pas reproduire de façon fiable une distribution cible, elle dérive d’un lot à l’autre, et elle ne peut pas être rejouée à partir d’une graine aléatoire.
La conception qui fonctionne inverse les rôles. Les statistiques viennent de la production. Le volume vient d’un moteur rapide et déterministe. Le LLM travaille en amont, au moment de la conception, et dans la boucle de rétroaction quand quelque chose échoue. Il ne produit jamais une seule ligne.
| Tâche | Qui la fait | Pourquoi |
|---|---|---|
| Mesurer distributions et corrélations | Profileur sur la production, à l’intérieur du périmètre | Les chiffres doivent être mesurés, pas imaginés |
| Produire des centaines de millions de lignes | Moteur statistique, vectorisé et à graine | Vitesse, coût et reproductibilité exacte |
| Traduire schémas et code en règles métier | Le LLM rédige, les ingénieurs relisent | Lit le DDL, les enums et le code de validation plus vite que n’importe quel analyste |
| Écrire les machines à états de cycle de vie et les invariants | Le LLM rédige, les ingénieurs approuvent | Transforme le savoir tribal en spécifications exécutables et testables |
| Construire les dictionnaires de base (noms, entreprises, libellés de commerçants, modèles de texte libre) | Le LLM les constitue une fois ; le moteur échantillonne | Un langage réaliste pour un coût marginal quasi nul |
| Expliquer les échecs de validation et proposer des corrections | Le LLM, dans la boucle de rétroaction | Raccourcit l’itération de plusieurs jours à quelques minutes |
En bref, le LLM est un compilateur de connaissance métier. Sa production, ce sont des règles et des dictionnaires versionnés, relus, puis exécutés des millions de fois. C’est là qu’il crée un effet de levier à grande échelle, et c’est exactement ce qui manquait à nos scénarios écrits à la main : une diversité encodée une fois, puis reproduite partout.
Ce qui change
Comprendre les limites des tests est la première étape. La suivante consiste à décider jusqu’où vous voulez aller. Vous pouvez commencer petit, en améliorant vos scénarios existants avec les principes ci-dessus, puis augmenter progressivement le volume et la diversité de vos données de test. Vous pouvez aussi commencer grand, en mettant en place un pipeline complet de génération de données de test, avec toutes les fonctionnalités décrites plus haut. Le choix vous appartient, il dépend de vos besoins et de vos ressources. Dans le prochain article, je couvrirai la seconde partie : la méthode pour générer les données.