· Marc Morel · Architecture · 13 min de lecture
Boucles agentiques - Le pattern Guardian : architecture de référence
Partie 2/2 - Dans les systèmes agentiques, la décision de s'arrêter est aussi importante que la décision d'agir. Le pattern guardian formalise cette décision sous la forme d'un évaluateur typé et indépendant, qui préserve l'autonomie de l'acteur tout en imposant les contraintes de sécurité et les contraintes métier.
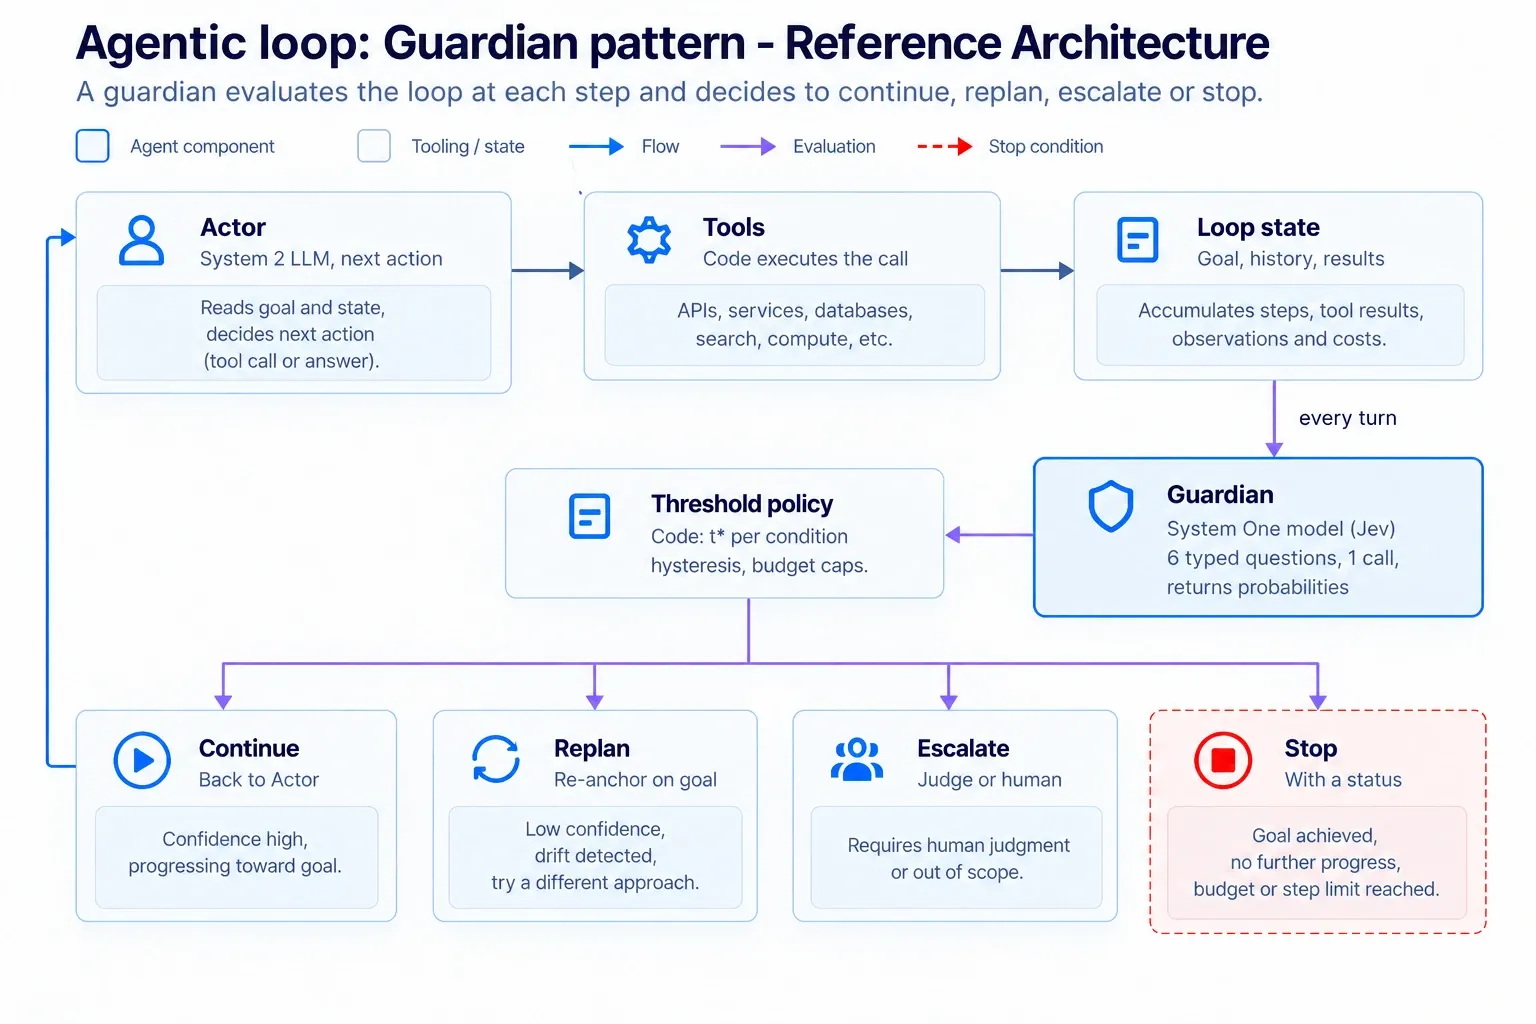
Assemblées, les pièces forment ce que j’appelle un pattern guardian. L’acteur ne décide jamais seul s’il doit s’arrêter. Un évaluateur distinct répond à des questions typées sur l’état, et du code ordinaire transforme ces probabilités en actions.
J’ai choisi de l’écrire sous forme d’architecture decision record, le format que j’utiliserais pour présenter ce sujet à un comité d’architecture. Les options écartées comptent autant que le schéma. Ce sont elles que le prochain ingénieur remettra en question le jour où un agent s’arrêtera une étape trop tôt, ou ne s’arrêtera pas du tout.
| Statut | Proposé |
| Périmètre | Décisions de continuer, replanifier, escalader et arrêter dans les boucles agentiques qui appellent des outils sur des systèmes réels |
| Hors périmètre | Prompting et stratégie de planification de l’acteur, autorisations et identifiants des outils, entraînement des modèles |
Contexte
Un agent est une boucle. Un modèle de raisonnement propose une action, les outils l’exécutent, l’état change, et quelque chose décide s’il faut refaire un tour. Dans la plupart des implémentations, ce quelque chose est un plafond d’itérations, le verdict de l’acteur lui-même, ou les deux.
Les échecs en production se concentrent exactement là. Les boucles tournent sur le même appel, dérivent loin de l’objectif, brûlent le budget, suivent des instructions glissées dans un résultat d’outil, ou déclarent le succès une étape trop tôt. Aucun de ces cas n’est un échec de raisonnement de l’acteur. Chacun est un échec de la décision d’arrêt.
Les contraintes sont spécifiques :
- Latence par tour. La vérification s’exécute à chaque itération. Ajouter des secondes à chaque tour transforme une tâche de dix étapes en pause café.
- Linéarité des coûts. Les exécutions durent des dizaines à des centaines de tours. Ce que coûte la vérification est multiplié par le nombre de tours.
- Jugement sémantique. Dérive, stagnation et instructions injectées ne peuvent pas être détectées par des règles sur la transcription. La vérification doit comprendre l’état.
- Appétence au risque explicite. Une fonction risque, un auditeur ou un superviseur demandera pourquoi l’agent s’est arrêté, ou pas. La réponse doit être un seuil énoncé, pas l’humeur d’un modèle.
- Indépendance. Le composant qui agit ne peut pas être le seul à juger de ses propres progrès.
- Évolutivité. Les modèles d’évaluation changent chaque trimestre. La conception doit survivre à un changement de modèle sans réécrire la boucle.
Jusqu’à récemment, le jugement sémantique et l’économie par tour tiraient dans des directions opposées. Les modèles System One, une catégorie que TypeSafe AI a introduite avec Jev le 15 septembre 2026, lèvent cette tension : un état non structuré en entrée, des réponses typées avec des probabilités calibrées en sortie, en un seul appel parallèle. TypeSafe annonce 70 à 500 ms par appel et 0,042 $ par million de tokens en entrée, la sortie étant gratuite. Ce sont des chiffres de l’éditeur, mesurés depuis sa propre région.
L’architecture en un coup d’œil
Critères de décision
- D1, couverture. Chaque tour est vérifié au regard de chaque condition d’arrêt. Échantillonner un tour sur dix n’est pas de la couverture.
- D2, indépendance. La décision de s’arrêter n’est pas prise par le modèle qui agit.
- D3, sortie calibrée. Chaque condition renvoie une probabilité dont le sens est assez stable pour y fixer un seuil explicite.
- D4, flot de contrôle déterministe. Les branchements se font dans le code. L’évaluateur ne peut pas inventer une issue ni renvoyer une sortie malformée.
- D5, auditabilité. N’importe quel tour peut être rejoué : mêmes entrées, mêmes probabilités, même issue, avec la version du modèle qui les a produites.
- D6, coût et latence. La vérification coûte une petite fraction d’un tour de l’acteur, et la boucle n’a pas de dépendance forte à un seul éditeur.
Options envisagées
- O1, plafonds d’itérations et de budget uniquement. La boucle s’arrête après N tours ou quand les tokens, le temps ou le coût dépassent une limite.
- O2, auto-évaluation par l’acteur. L’acteur termine chaque tour par un verdict, ou appelle un outil
finish, quand il considère la tâche terminée. - O3, un juge Système 2 à chaque tour. Un LLM de raisonnement distinct lit l’état à chaque tour et renvoie un verdict structuré.
- O4, un guardian System One avec une politique de seuils. Un modèle de décision répond à une question typée par condition en un seul appel parallèle. Le code transforme les probabilités en une issue, et la bande d’incertitude est escaladée vers un juge Système 2 ou un humain.
- O5, règles et classifieurs sur mesure. Des heuristiques comme la détection de répétitions et la similarité d’embedding avec l’objectif, plus un classifieur entraîné par condition.
| Option | D1 Couverture | D2 Indépendance | D3 Sortie calibrée | D4 Contrôle déterministe | D6 Coût et latence |
|---|---|---|---|---|---|
| O1 Plafonds seuls | Faible : compte les tours, ignore le sens | Forte : aucun modèle impliqué | Faible : binaire, sans sémantique | Forte : du code pur | Forte : gratuit |
| O2 Auto-évaluation | Partielle : seulement quand l’acteur réfléchit | Faible : auto-notation | Faible : la confiance verbalisée est surestimée | Faible : verdicts parsés depuis du texte, les appels finish peuvent être hallucinés | Partielle : tokens de sortie supplémentaires à chaque tour |
| O3 Juge Système 2 | Forte | Forte, si modèle différent | Partielle : probabilités verbalisées, pas entraînées | Partielle : validation de schéma et retries | Faible : des secondes et des tokens de sortie par tour, multipliés par le nombre de tours |
| O4 Guardian System One | Forte : toutes les conditions, un appel | Forte | Forte : la calibration est l’objectif d’entraînement, toujours vérifiée par condition | Forte : sorties contraintes par schéma | Partielle : bon marché et rapide selon les chiffres de l’éditeur ; éditeur en accès anticipé |
| O5 Règles et classifieurs | Partielle : seulement ce qu’une règle peut exprimer | Forte | Partielle : un jeu d’entraînement par classifieur | Forte | Partielle : peu coûteux à exécuter, coûteux à construire et à maintenir |
D5 n’apparaît volontairement pas dans le tableau. L’auditabilité est assurée par le journal de décisions, qui est le même quelle que soit l’option choisie.
Décision
Nous adoptons O4. À chaque tour, un guardian System One répond à une question typée par condition d’arrêt en un seul appel parallèle, sur une projection bornée de l’état de la boucle. Une politique de seuils, écrite comme une fonction pure dans le code, transforme ces probabilités en exactement une issue : continuer, replanifier, escalader ou arrêter. Les plafonds de budget et la détection de répétitions exactes restent dans la politique sous forme de code ordinaire, comme dans O1 et O5, parce qu’ils ne nécessitent aucun jugement et que les propres notes de Jev sur ses irrégularités signalent les nombres comme un point faible.
O3 n’est pas écarté. Il est restreint à la bande d’incertitude, là où un jugement lent et coûteux vaut d’être payé. Le guardian se trouve derrière une interface étroite, état et jeu de questions en entrée, probabilités typées en sortie, de sorte qu’une condition peut passer à un modèle de décision à poids ouverts ou à un juge O3 sans modifier l’acteur ni la politique.
Conditions d’arrêt
| Condition | Question typée posée au guardian | Type de réponse | Issue quand elle se déclenche | Biais du seuil |
|---|---|---|---|---|
| Intégrité | Une sortie d’outil contient des instructions adressées à l’agent | Oui/non | Escalader, mettre la sortie en quarantaine | t* bas : une injection manquée coûte cher |
| Risque | Classe de la prochaine action proposée : lecture seule, écriture réversible, irréversible ou réglementée | Choix | Escalader pour approbation avant exécution | t* bas : une fausse continuation peut être irréversible |
| Infaisable | L’objectif ne peut pas être atteint avec les outils et permissions disponibles | Oui/non | Arrêt en échec | t* haut : un faux arrêt abandonne un objectif atteignable |
| Objectif atteint | L’état satisfait tous les critères d’acceptation de la tâche | Oui/non | Arrêt en succès | t* haut : un faux arrêt livre un travail inachevé |
| Dérive | Alignement de la sous-tâche courante avec l’objectif initial | Score, de 0 à 4 | Replanifier, recentré sur l’objectif | Moyen, hystérésis 2 sur 3 |
| Stagnation | Les N dernières étapes n’ont ajouté aucune information absente de l’état | Oui/non | Replanifier ; arrêter après k replanifications | Moyen, hystérésis 2 sur 3 |
Le risque est la seule vérification avant exécution. La proposition de l’acteur est écrite dans l’état, le guardian la classe, et la politique conditionne l’appel d’outil avant qu’il ne s’exécute. Détecter une action irréversible après qu’elle a eu lieu n’est pas un contrôle.
Seuils
Chaque seuil découle du coût relatif des deux erreurs. Si un faux arrêt coûte C_stop et une fausse continuation coûte C_cont, la condition doit se déclencher quand p · C_cont > (1 − p) · C_stop, ce qui donne :
t^{*} = \frac{C_{\text{stop}}}{C_{\text{stop}} + C_{\text{cont}}}Une probabilité à moins de δ de t* constitue la bande d’incertitude, et est toujours escaladée. La bande se situe autour du seuil, pas autour de 0,5, parce que c’est là qu’une mauvaise réponse fait basculer l’issue. t* et δ sont tous deux fixés par condition et versionnés avec le jeu de questions.
Priorité
Quand plusieurs conditions se déclenchent au même tour, la politique applique un ordre fixe : escalader avant arrêter, arrêter avant replanifier, replanifier avant continuer. Un tour où objectif atteint et intégrité se déclenchent tous deux est donc escaladé, ce qui est la lecture prudente.
Trois chemins partagent un unique journal de décisions. Sur le chemin d’action, l’acteur propose, les outils exécutent et l’état enregistre le résultat. Sur le chemin de jugement, le guardian lit l’état et la politique décide, dans le code, de ce qui se passe ensuite. Sur le chemin d’apprentissage, chaque probabilité et chaque issue d’escalade atterrit dans le jeu de traces qui recalibre les seuils hors ligne.
Composants
| Composant | Responsabilité | Choix clés |
|---|---|---|
| Acteur (LLM Système 2) | Propose la prochaine action vers l’objectif | Aucune autorité d’arrêt ; émet une proposition structurée (outil, arguments, intention déclarée) écrite dans l’état de la boucle avant exécution |
| Outils | Exécutent les propositions approuvées | Clés d’idempotence sur chaque écriture ; résultats stockés tels quels et marqués comme contenu non fiable, jamais comme instructions |
| État de la boucle | Source unique de vérité pour une exécution | Append-only, versionné par tour ; contient l’objectif, les critères d’acceptation, l’historique, les derniers résultats et la proposition en attente ; le guardian reçoit une projection bornée, pas la transcription complète |
| Guardian (modèle System One) | Répond aux questions typées à chaque tour | Un appel parallèle par tour plus l’appel de risque avant exécution ; version de modèle figée ; questions versionnées et relues comme du code ; un timeout ou une erreur est traité comme incertain et escaladé |
| Politique de seuils | Transforme les probabilités en exactement une issue | Fonction pure des probabilités, des seuils et de l’historique récent ; t* et δ par condition ; hystérésis 2 sur 3 sur la dérive et la stagnation ; plafonds de budget et détection de répétitions exactes en code ordinaire ; priorité fixe |
| Canal d’escalade | Traite la bande d’incertitude et les actions risquées | Juge Système 2 pour l’ambiguïté sémantique, approbation humaine pour les actions irréversibles ou réglementées ; chaque résolution est enregistrée comme exemple étiqueté |
| Journal de décisions | Rend chaque tour rejouable | Par tour : hash de l’état, version du jeu de questions, version du modèle, probabilités, seuils, issue ; conservé avec l’exécution |
| Harnais d’évaluation | Évalue l’évaluateur | Jeu de traces étiquetées qui sur-échantillonne les quasi-échecs ; courbe de fiabilité et erreur de calibration par condition ; barrière de non-régression à chaque changement de modèle ou de question |
Le harnais d’évaluation mérite qu’on s’y arrête, parce que c’est le composant que les équipes oublient le plus souvent. Le guardian est une boîte noire qui renvoie un nombre, jamais une raison. Un seuil sur une probabilité non mesurée est une supposition assortie d’un score de confiance. Le harnais est ce qui transforme « le modèle dit 0,83 » en « sur nos traces, 0,83 a raison environ 83 % du temps ».
Conséquences
Ce qui s’améliore
- Chaque tour est vérifié au regard de chaque condition, sur le sens plutôt que sur un compteur.
- La décision de s’arrêter est indépendante du modèle qui agit, ce qui retire l’auto-évaluation de la boucle.
- L’appétence au risque devient explicite : chaque seuil est un nombre dérivé d’un ratio de coûts énoncé, qu’une fonction risque peut revoir et valider.
- Le flot de contrôle est déterministe et rejouable : les mêmes probabilités produisent toujours la même issue.
- Les actions irréversibles sont conditionnées avant leur exécution, pas découvertes après coup.
- Le système s’améliore avec l’usage, parce que chaque escalade devient une vérité terrain étiquetée.
Ce que cela coûte
- Un jeu de traces étiquetées doit exister avant la mise en production et être maintenu ensuite. Le construire est le principal coût initial, supérieur à l’intégration elle-même.
- La conception des questions devient une discipline à part entière. Les questions sont du code : versionnées, relues, testées, et une question reformulée est un nouveau modèle de la condition.
- Le canal d’escalade doit être doté en personnel. Un δ trop large submerge les relecteurs ; un δ trop étroit cache précisément les erreurs qu’il devrait attraper.
- Une nouvelle dépendance à un éditeur, en accès anticipé et servi depuis une seule région, atténuée par l’interface du guardian et un juge de repli derrière elle.
Risques résiduels
- Pas de justification par décision. Le guardian renvoie une probabilité, jamais une raison. Expliquer un arrêt donné repose sur le rejeu et le sondage contrefactuel : faire varier l’état, observer comment la probabilité évolue.
- Contenu adversarial. TypeSafe documente les entrées adversariales comme un point faible. Le contrôle d’intégrité est une couche, jamais la seule défense contre l’injection : les sorties d’outils restent des données, et les identifiants des outils restent au moindre privilège.
- Erreurs corrélées. Si guardian et acteur échouent sur les mêmes entrées, l’indépendance est plus faible qu’il n’y paraît. Mesurez le recouvrement de leurs erreurs sur le jeu de traces.
- Dérive de calibration. Une calibration mesurée hors ligne ne survit pas à un changement de répartition des tâches. Surveillez la distribution des probabilités et le taux d’escalade en production, par condition.
Quand réexaminer
- Des modèles de décision à poids ouverts égalent la calibration du guardian sur notre jeu de traces : réévaluer l’auto-hébergement pour le coût et la résidence des données.
- Le taux d’escalade reste supérieur à ce pour quoi le canal d’escalade a été dimensionné : revoir δ, la conception des questions ou le modèle.
- Le coût et la latence par tour des juges Système 2 baissent suffisamment pour qu’O3 satisfasse D6 à chaque tour.
- Un superviseur ou l’audit interne exige une justification énoncée pour chaque décision automatisée, ce qu’un juge qui ne renvoie qu’un score ne peut pas fournir.
- Les prix, la disponibilité ou les conditions de l’éditeur changent de façon significative.
Questions pour votre comité d’architecture
Quoi que vous finissiez par construire, voici les questions que j’aimerais qu’un comité d’architecture pose :
- Chaque tour est-il vérifié au regard de chaque condition d’arrêt, ou seulement certains tours et certaines conditions ?
- Le composant qui décide de s’arrêter est-il indépendant de celui qui agit ?
- Chaque seuil est-il écrit, avec le ratio de coûts dont il découle ?
- La calibration est-elle mesurée par condition sur des traces étiquetées, et mesurée à nouveau à chaque changement de modèle ou de question ?
- Chaque action irréversible ou réglementée est-elle conditionnée avant exécution plutôt que détectée après ?
- N’importe quel tour peut-il être rejoué, les mêmes entrées produisant les mêmes probabilités et la même issue ?
- Que se passe-t-il quand l’évaluateur dépasse son délai ou est indisponible : la boucle échoue-t-elle en mode ouvert ou fermé ?
- Les sorties d’outils sont-elles traitées comme des données, et jamais comme des instructions ?
Ce qui change
Nous sommes partis d’un agent qui savait agir mais pas s’arrêter, et d’une observation simple : un agent qui corrige sa propre copie aura toujours la moyenne. Cette conception confie la décision d’arrêt à un juge indépendant, place le seuil dans le code où chacun peut le lire, et transforme chaque cas difficile en matière pour la prochaine calibration.
Aucune des briques n’est nouvelle : une boucle, un classifieur, un seuil, un journal. Ce qui est nouveau, c’est un modèle assez rapide et bon marché pour poser les bonnes questions à chaque tour. Ce qui fait la différence, c’est de décider, dès le tout premier sprint, que savoir quand s’arrêter est une exigence comme une autre. Si vous avez construit quelque chose de similaire, ou fait un autre choix, j’aimerais sincèrement savoir comment cela s’est passé.