· Marc Morel · Architecture · 8 min de lecture
Savoir s'arrêter : boucles agentiques et évaluateurs « System One »
Partie 1/2 - Un agent ne vaut que ce que valent ses conditions de sortie. La plupart des échecs ne sont pas de mauvais premiers pas, mais des boucles qui ne s'arrêtent jamais. Cet article défend une idée simple : les conditions d'arrêt doivent être des evals à part entière, vérifiées à chaque itération. Une nouvelle classe de modèles, que TypeSafe AI appelle les modèles System One, rend cela économiquement réaliste pour la première fois.
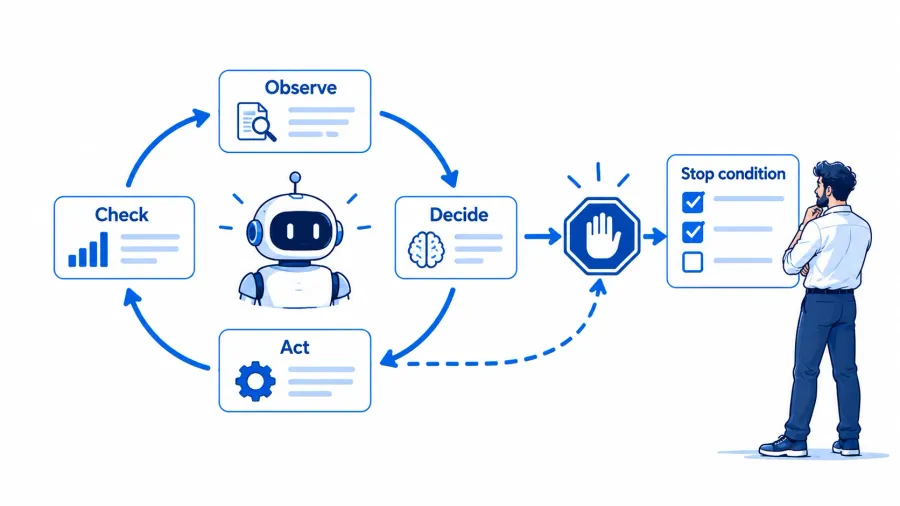
Le plus difficile pour un agent, c’est de savoir quand s’arrêter
Un agent est une boucle, et une boucle ne vaut que ce que valent ses conditions de sortie. La plupart des échecs d’agents que j’ai vus en production n’étaient pas de mauvais premiers pas. C’étaient des boucles qui ne voulaient pas s’arrêter : qui tournaient sur le même appel d’outil, qui dérivaient loin de l’objectif initial, qui brûlaient discrètement le budget, ou qui criaient victoire une étape trop tôt.
Nous consacrons beaucoup d’énergie au modèle de raisonnement au centre de la boucle. Nous en consacrons beaucoup moins au petit jugement répété qui décide si la boucle doit continuer. Ce jugement mérite d’être conçu et évalué comme n’importe quel autre composant critique.
Cet article défend une idée simple. Les conditions d’arrêt doivent être des evals à part entière, vérifiées à chaque itération. Une nouvelle classe de modèles, que TypeSafe AI appelle les modèles System One et dont le premier, Jev, a été livré le 15 septembre 2026, rend cela économiquement réaliste pour la première fois.
Anatomie d’une boucle agentique
Retirez les frameworks et tous les agents exécutent le même cycle. Le modèle propose, le monde répond, et quelque chose décide s’il faut refaire un tour.
- Observer. Assembler l’état courant : l’objectif, l’historique, les derniers résultats d’outils.
- Décider. Un modèle de raisonnement choisit la prochaine action. C’est un travail lent, délibéré, de type Système 2.
- Agir. Le code exécute l’appel d’outil : une requête, une modification de fichier, un appel d’API.
- Évaluer. Quelque chose juge le nouvel état au regard de l’objectif et des garde-fous.
- Continuer ou s’arrêter. L’orchestrateur repart à l’étape 1 ou sort avec un statut.
Le point de conception important, c’est où se trouve le contrôle. La politique est un modèle, mais la condition du while est du code. L’étape 4 est le pont entre les deux, et c’est là que la plupart des équipes prennent des raccourcis.
Les deux raccourcis habituels échouent de façon prévisible. Un plafond max_iterations fixe est aveugle au sens : il arrête une exécution saine à l’étape 20 et laisse une exécution sans espoir en consommer 19. Demander au modèle qui agit « as-tu fini ? » est pire. C’est de l’auto-évaluation, cela ajoute des secondes de latence à chaque tour, et cela renvoie une opinion en prose plutôt qu’une probabilité sur laquelle poser un seuil.
Une taxonomie des conditions d’arrêt
Une boucle doit pouvoir s’arrêter pour plus d’une raison, et chaque raison mérite sa propre question. Sept méritent d’être nommées explicitement ; le budget est la seule qui ne nécessite aucun modèle.
| Condition | La question que pose l’évaluateur | Action quand elle se déclenche |
|---|---|---|
| Objectif atteint | L’état courant satisfait-il tous les critères d’acceptation de la tâche ? | Sortie en succès |
| Infaisable | L’objectif est-il hors d’atteinte avec les outils et permissions disponibles ? | Sortie et escalade |
| Stagnation | Les N dernières étapes ont-elles produit une information que l’agent n’avait pas déjà ? | Replanifier, puis sortir si cela persiste |
| Dérive | La sous-tâche courante sert-elle toujours l’objectif initial ? | Se recentrer sur l’objectif |
| Risque | La prochaine action proposée touche-t-elle quelque chose d’irréversible ou de réglementé ? | Pause pour approbation humaine |
| Intégrité | Une sortie d’outil tente-t-elle d’instruire l’agent plutôt que de l’informer ? | Mettre la sortie en quarantaine, alerter |
| Budget | Tokens, temps écoulé ou coût au-dessus de la limite ? | Arrêt ferme, code déterministe |
Regardez la forme de ces questions. Elles ne sont pas ouvertes. Chacune est un jugement étroit et typé sur un état structuré : un oui/non, un choix parmi quelques options, ou un score sur une échelle.
Elles nécessitent aussi une vraie compréhension sémantique. Aucune expression régulière ne peut vous dire si une sous-tâche a dérivé. Cette combinaison, une sortie étroite mais une compréhension réelle, est exactement ce pour quoi un modèle System One est conçu.
Pourquoi les modèles System One ont leur place dans le siège de l’évaluateur
Le nom vient de Daniel Kahneman. Le Système 2 est lent et délibéré ; le Système 1 est rapide et intuitif. Les LLM de raisonnement actuels, avec leurs longues chaînes de pensée, relèvent clairement du Système 2. C’est le bon outil pour décider quoi faire ensuite, et le mauvais pour vérifier, quarante fois par exécution, s’il faut continuer.
Jev, de TypeSafe AI, est le premier modèle conçu pour l’autre côté. Il ne génère pas de texte. Vous lui envoyez un état et un ensemble de questions typées ; il renvoie des réponses typées avec des probabilités. Les notes de Simon Willison décrivent trois types de questions : des affirmations oui/non notées entre 0 et 1, un choix parmi des options fournies avec une distribution complète, et un score le long d’une échelle décrite. Toutes les questions reçoivent une réponse en une seule passe parallèle.
L’article de lancement de TypeSafe annonce une latence de bout en bout de 70 à 500 ms, une entrée à 0,042 $ par million de tokens et une sortie gratuite. Considérez-les comme des chiffres de l’éditeur, mesurés depuis sa propre région. Même avec une sérieuse décote, l’ordre de grandeur change ce que vous pouvez vous permettre de vérifier.
Pour les conditions d’arrêt, quatre propriétés comptent davantage que la vitesse brute :
- Des probabilités calibrées. Une probabilité vous permet de fixer un seuil par condition et d’arbitrer délibérément entre faux arrêts et fausses continuations, au lieu de vous fier à une phrase assurée.
- Des questions parallèles. Les sept conditions tiennent dans un seul appel, donc la vérification s’exécute à chaque itération plutôt qu’une sur dix.
- La sûreté de typage. L’évaluateur ne peut pas inventer une quatrième branche ni renvoyer du JSON malformé. Le flot de contrôle reste dans votre code, là où il doit être.
- L’indépendance. Le juge est un modèle différent de l’acteur. Cela supprime le biais d’auto-évaluation qui consiste à demander à l’agent de corriger sa propre copie.
Les limites méritent la même honnêteté. Les notes publiées sur les irrégularités de Jev signalent des faiblesses sur les nombres, les dates et les contenus adversariaux, ce qui compte pour l’arithmétique du budget et pour le contrôle d’intégrité. C’est aussi une boîte noire : vous obtenez un nombre, jamais une justification. La conclusion de Willison est la bonne. Avec un modèle de ce type, les evals deviennent plus importantes, pas moins, et l’évaluateur lui-même doit être évalué.
Concevoir des evals pour les conditions d’arrêt
Une condition d’arrêt est un classifieur auquel est attachée une fonction de coût. Évaluez-la comme telle et l’essentiel de la conception se met en place.
Écrire des questions réfutables. « L’agent s’en sort-il bien ? » ne peut pas être évalué. « La suite de tests est-elle passée depuis la dernière modification de code ? » le peut. Chaque question doit faire référence à des champs concrets de l’état de la boucle, pas à l’impression générale laissée par la transcription.
Constituer un jeu de traces étiquetées. Rejouez de vraies exécutions d’agents et étiquetez chaque étape pour chaque condition. Sur-échantillonnez les cas difficiles : quasi-échecs, succès prématurés, dérives lentes. Un modèle de raisonnement frontier peut rédiger des étiquettes « argent » ; des humains tranchent là où il se contredit ou contredit l’évaluateur.
Mesurer la calibration, pas seulement l’exactitude. Un seuil n’a de sens que si 0,8 signifie vraiment juste environ 80 % du temps. Tracez une courbe de fiabilité par condition et suivez une métrique d’erreur de calibration à côté de la précision et du rappel.
Fixer les seuils à partir des coûts, pas des goûts. Un faux arrêt et une fausse continuation coûtent rarement la même chose. Si s’arrêter à tort coûte C_stop et continuer à tort coûte C_cont, arrêtez quand le coût attendu de la continuation dépasse celui de l’arrêt :
Pour la condition de risque, continuer à tort peut signifier un paiement irréversible, donc le seuil est bas et le rappel l’emporte. Pour l’objectif atteint, s’arrêter à tort livre un travail inachevé, donc le seuil est haut et la précision l’emporte.
Ajouter de l’hystérésis. Stagnation et dérive sont bruitées d’une étape à l’autre. Exigez que la condition soit vraie sur deux des trois dernières itérations avant d’agir, pour que la boucle n’oscille pas entre replanification et continuation.
Router la zone d’incertitude. Les probabilités entre environ 0,4 et 0,6 sont là où l’évaluateur bon marché est le moins utile. Envoyez cette bande à un juge Système 2 ou à un humain, et enregistrez le résultat comme un nouvel exemple étiqueté.
Versionner l’évaluateur. Les modèles des éditeurs changent. Figez la version du modèle, conservez le jeu de traces comme suite de non-régression, et relancez-la avant chaque mise à jour, exactement comme pour une montée de version de dépendance.
Ce qui change
Laissez le modèle lent réfléchir, laissez le modèle rapide surveiller
Nous ferons confiance aux agents non pas quand ils deviendront brillants, mais quand ils deviendront bornés. Borné signifie que chaque boucle sait pourquoi elle peut s’arrêter, le vérifie à chaque tour, et peut montrer les chiffres derrière cette vérification.
Les modèles System One ne remplacent pas le modèle de raisonnement ; ils l’entourent. Si vous ne retenez qu’une chose de cet article, que ce soit celle-ci : écrivez vos conditions d’arrêt sous forme de questions, étiquetez quelques centaines de traces réelles en regard, et choisissez vos seuils en fonction de ce que coûte réellement une mauvaise décision. Le modèle que vous utilisez pour la vérification compte moins que la discipline consistant à l’évaluer.
J’aimerais beaucoup savoir comment vous gérez les conditions de sortie dans vos propres agents, et où ce pattern atteint ses limites.